

- Updated: December 4, 2025
- 7 min read
Transformers ve MoE: Model Kapasitesi, Parametre Kullanımı ve Maliyet Analizi – AI Güncel Haberleri
Transformers ve Mixture of Experts (MoE) modelleri, parametre kullanımı, inference maliyeti, token yönlendirme ve model kapasitesi açısından farklılık gösterir; MoE, toplam parametre sayısını artırırken aynı anda yalnızca bir alt kümesini aktif tutarak daha düşük işlem maliyeti ve daha yüksek ölçeklenebilirlik sunar.
Giriş
Derin öğrenme alanında son yıllarda Transformers ve Mixture of Experts (MoE) mimarileri, büyük dil modellerinin (LLM) temel yapıtaşları olarak öne çıkmıştır. Bu iki yaklaşım arasındaki farkları anlamak, hem araştırmacılar hem de üretim ortamlarında çalışan mühendisler için kritik bir adımdır. Daha detaylı bir inceleme için orijinal makaleye göz atabilirsiniz.
Transformers vs MoE – Genel Bakış
Parametre Kullanımı
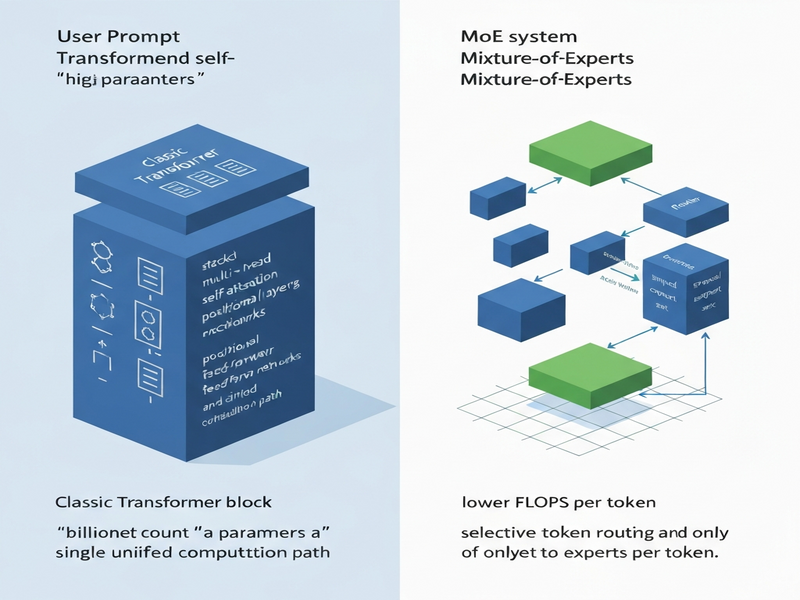
Transformers mimarisi, her katmanda tek bir büyük Feed‑Forward Network (FFN) barındırır ve gelen her token bu FFN’den geçer. Bu durum, modelin tüm parametrelerini her adımda aktif eder:
- Her token, tüm katmanların ağırlıklarını işler.
- Parametre yoğunluğu yüksek, dolayısıyla bellek tüketimi de fazladır.
MoE ise aynı FFN’i birden çok uzman (expert) ağına bölerek, router aracılığıyla sadece k (genellikle 2‑4) uzmanı seçer. Böylece toplam parametre sayısı artarken, bir token başına kullanılan parametre sayısı sabit kalır.
Model Kapasitesi
Model kapasitesi, bir ağın karmaşık ilişkileri öğrenebilme gücünü ifade eder. Transformers’da kapasiteyi artırmak için iki ana yol vardır:
- Katman sayısını artırmak,
- FFN genişliğini (hidden size) büyütmek.
Her iki yöntem de FLOPs ve bellek ihtiyacını lineerden daha hızlı artırır. MoE ise parametre sayısını katlanarak artırırken aynı token başına işlem maliyetini düşük tutar; bu, “büyük beyin, düşük çalışma maliyeti” ilkesini mümkün kılar. Örneğin, Mixtral 8×7B modeli 46.7 B toplam parametreye sahiptir, ancak bir token sadece ~13 B parametreyi işler.
İnference Maliyeti
İnference aşamasında, Transformers tüm ağı çalıştırdığı için yüksek GPU bellek ve enerji tüketimi gerektirir. 70 B parametreli bir model, genellikle birden fazla A100 GPU’da çalıştırılmalıdır.
MoE ise Top‑K routing sayesinde sadece seçilen uzmanları devreye alır. Bu, aynı model boyutunda bile daha düşük gecikme ve maliyet anlamına gelir. Özellikle bulut ortamlarında ölçeklenebilirlik ve maliyet optimizasyonu açısından MoE büyük avantaj sağlar.
Token Yönlendirme (Routing)
Transformers’da tokenlar sabit bir yol izler; her katmanda aynı işlemler uygulanır. MoE’da ise bir router ağı (genellikle düşük boyutlu bir MLP) tokenları uzmanlara yönlendirir:
- Router, tokenın temsilini alıp softmax üzerinden uzman olasılıklarını hesaplar.
- En yüksek olasılıklı k uzman seçilir (Top‑K).
- Her token farklı uzman kombinasyonuna gidebilir, bu da uzmanların uzmanlaşmasını sağlar.
Avantajlar ve Dezavantajlar
Transformers
- Basit eğitim süreci: Tek bir akış, router gibi ek bileşen yok.
- Deterministik davranış: Her token aynı yolu izler, hata ayıklama kolay.
- Geniş topluluk ve araç desteği: Hugging Face, PyTorch, TensorFlow gibi ekosistemlerde kapsamlı destek.
- Yüksek inference maliyeti: Büyük modellerde GPU bellek sınırları sıkıntı yaratır.
- Ölçekleme sınırlamaları: Parametre eklemek, FLOPs ve enerji tüketimini lineerden daha hızlı artırır.
Mixture of Experts (MoE)
- Parametre verimliliği: Toplam parametre sayısı yüksek, ancak aktif parametre sayısı düşük.
- Düşük inference maliyeti: Sadece seçilen uzmanlar çalışır, bu da daha az GPU bellek ve daha hızlı yanıt süresi demektir.
- Model kapasitesinde büyük artış: Uzman sayısını artırarak kapasiteyi katlanarak büyütmek mümkün.
- Uzmanlaşma: Farklı tokenlar farklı uzmanlara yönlendirildiği için uzmanlar belirli görevlerde uzmanlaşabilir.
- Eğitim zorluğu: Router çökmesi (expert collapse) ve yük dengesizliği gibi problemler ek düzenleme gerektirir.
- Ek altyapı gereksinimi: Router, kapasite sınırları ve uzman yük dengeleme mekanizmaları ek kod ve donanım karmaşıklığı getirir.
Pratik Uygulamalar ve UBOS Entegrasyonları
Türkiye’de ve dünyada AI araştırmacıları, Transformers ve MoE mimarilerini farklı iş senaryolarına entegre ederken, UBOS homepage üzerinden kapsamlı bir platforma erişebilirler. UBOS, hem UBOS platform overview hem de Enterprise AI platform by UBOS gibi çözümlerle büyük modellerin yönetimini basitleştirir.
Özellikle UBOS for startups ve UBOS solutions for SMBs segmentleri, düşük maliyetli inference ihtiyacını karşılamak için MoE tabanlı servisler sunar. Bu servisler, Web app editor on UBOS ve Workflow automation studio ile hızlı prototipleme ve otomasyon imkanı tanır.
Fiyatlandırma konusunda UBOS pricing plans esnek paketler sunar; büyük ölçekli MoE modelleri için “pay‑as‑you‑go” modeli, startup’ların bütçelerini zorlamaz. Gerçek dünya örnekleri UBOS portfolio examples sayfasında incelenebilir.
UBOS ayrıca UBOS templates for quick start aracılığıyla hazır şablonlarla modelleri hızla dağıtma olanağı verir. Örneğin, AI SEO Analyzer ve AI Article Copywriter şablonları, içerik üretiminde Transformers’ın gücünü, MoE’nin verimliliğiyle birleştirir.
Entegrasyon açısından, UBOS Telegram integration on UBOS, ChatGPT and Telegram integration ve OpenAI ChatGPT integration gibi popüler AI hizmetleriyle sorunsuz bağlanma sağlar. Veri yönetiminde Chroma DB integration ve sesli yanıt sistemlerinde ElevenLabs AI voice integration gibi entegrasyonlar, MoE tabanlı uygulamaların üretim ortamına geçişini hızlandırır.
“MoE mimarileri, büyük parametre havuzlarını verimli bir şekilde kullanarak, gerçek zamanlı uygulamalarda maliyet ve gecikme sorunlarını büyük ölçüde azaltıyor.” – UBOS AI Mühendisliği Ekibi
Gelecek Perspektifi
AI araştırmalarının geleceği, model kapasitesi ve verimlilik dengesine odaklanacak. Transformers hâlâ doğal dil işleme (NLP) ve çok-modelli görevlerde temel yapıtaşı olmaya devam ederken, MoE’nin sparse compute yaklaşımı, özellikle edge AI ve large‑scale serving senaryolarında tercih edilecek.
UBOS, Transformer modelleri ve MoE teknolojisi üzerine sürekli güncellenen dokümantasyon ve topluluk desteği sunarak, araştırmacıların ve geliştiricilerin bu iki mimariyi birleştiren hibrit çözümler üretmesini kolaylaştırıyor.
Önümüzdeki yıllarda beklenen trendler:
- Hybrid Architectures: Transformers ve MoE katmanlarını aynı model içinde birleştirerek hem genel yetenek hem de uzmanlaşmış görev performansı elde etmek.
- Dynamic Routing Gelişmeleri: Router algoritmalarının daha az bellek tüketen ve daha hızlı karar veren versiyonları.
- Enerji Verimliliği: MoE’nin düşük aktif parametre sayısı, sürdürülebilir AI altyapılarının temelini oluşturacak.
- Uygulama Odaklı Şablonlar: UBOS gibi platformların, sektörel şablonları (ör. GPT-Powered Telegram Bot, AI Video Generator) sayesinde hızlı prototipleme sürecini kısaltması.
Sonuç
Özetle, Transformers ve Mixture of Experts (MoE) modelleri, aynı temel yapıtaşını (self‑attention) paylaşsalar da, parametre kullanım stratejileri, inference maliyeti, token yönlendirme ve model kapasitesi açısından farklılık gösterir. Transformers, basitlik ve geniş topluluk desteği sunarken, MoE yüksek parametre kapasitesiyle düşük işlem maliyetini birleştirir. Türkiye’deki AI topluluğu ve işletmeler, bu iki mimariyi About UBOS gibi platformlar aracılığıyla deneyimleyerek, projelerinin ölçeklenebilirliğini ve maliyet etkinliğini artırabilir.
İleri seviye AI projelerinizde hangi mimarinin daha uygun olduğunu belirlemek için, model gereksinimlerinizi, donanım kısıtlamalarınızı ve iş hedeflerinizi göz önünde bulundurmanız gerekir. UBOS, bu karar sürecinde size kapsamlı dokümantasyon, hazır şablonlar ve esnek fiyatlandırma seçenekleriyle yanıt verir.
Bu makaleyi beğendiyseniz, UBOS partner program aracılığıyla iş birliği fırsatlarını keşfedebilir ve AI ekosisteminde yerinizi alabilirsiniz.
Andrii Bidochko
CTO UBOS
Andrii Bidochko is an AI entrepreneur and researcher focused on AI agents, reinforcement learning, and autonomous systems. He writes about the technologies shaping the future of machine intelligence, from frontier models and agent architectures to real-world AI applications.