

- Updated: December 5, 2025
- 6 min read
PostgreSQL Lookup Tablosu vs Enum Tipi: Performans ve Kullanım Kılavuzu
PostgreSQL’de lookup table ve enum type, veri bütünlüğü, sorgu performansı ve bakım kolaylığı açısından farklı avantajlar sunar; doğru seçim, uygulamanın ihtiyaçlarına ve veri modelleme stratejisine bağlıdır.
Giriş ve Başlık
PostgreSQL geliştiricileri ve veri tabanı yöneticileri, sabit değerlerin yönetiminde iki popüler yöntemi karşılaştırırken sıkça “lookup table vs. enum type” sorusunu sorarlar. Bu makalede, PostgreSQL lookup table ve PostgreSQL enum type kavramlarını tanımlayacak, performans ve kullanım senaryolarını inceleyecek, avantaj‑dezavantajlarını ortaya koyacak ve en iyi uygulamaları veri tabanı tasarımı perspektifinden değerlendireceğiz.
İçerikte, orijinal kaynağa yönlendiren bir dış bağlantı ve UBOS ekosistemindeki ilgili sayfalara doğal iç linkler bulacaksınız.
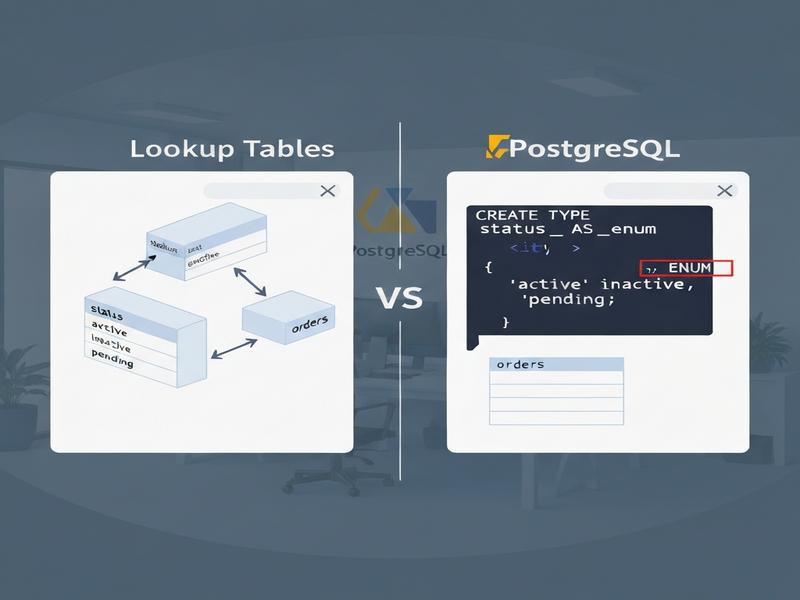
Lookup Table ve Enum Type Tanımı
Lookup Table Nedir?
Lookup table, sabit değerlerin ayrı bir tablo olarak saklandığı bir referans tablosudır. Genellikle iki sütun içerir: birincisi id (primary key), ikincisi ise value (görsel/işlevsel değer). Diğer tablolar bu tabloya foreign key ile bağlanır.
Enum Type Nedir?
PostgreSQL’in yerleşik enum veri tipi, bir sütunun alabileceği sınırlı değer kümesini tanımlar. Örneğin:
CREATE TYPE status AS ENUM ('pending', 'active', 'closed');Bu tip, doğrudan tablo tanımına eklenir ve değerler sabit bir liste içinde saklanır.
Performans ve Kullanım Senaryoları
Her iki yaklaşım da farklı performans profilleri sunar. Aşağıdaki tablo, kritik ölçütleri yan yana karşılaştırır:
| Kriter | Lookup Table | Enum Type |
|---|---|---|
| Ekleme/Değişiklik | INSERT/UPDATE sadece referans tablosunda yapılır; uygulama kodunda değişiklik gerekmez. | Yeni değer eklemek için ALTER TYPE … ADD VALUE gerekir; bu işlem tablo kilitlemesi yapabilir. |
| Sorgu Hızı | JOIN üzerinden erişim, indeksli ise hızlıdır; ancak ek bir JOIN maliyeti vardır. | Doğrudan sütun içinde saklandığı için ek JOIN yoktur; karşılaştırma sabit zamanlıdır. |
| Veri Bütünlüğü | Foreign key kısıtlamaları sayesinde tam bütünlük sağlanır. | Enum tipinin kendisi bütünlük sağlar; ancak dışarıdan ekleme mümkün değildir. |
| Bakım ve Genişletilebilirlik | Yeni değer eklemek sadece bir satır eklemek demektir. | Yeni değer eklemek ALTER TYPE gerektirir ve büyük tablolarda riskli olabilir. |
Tipik Kullanım Senaryoları
- Lookup Table: Sık sık değişen kod listeleri (ülke kodları, ürün kategorileri, dinamik fiyat grupları).
- Enum Type: Değişmesi neredeyse imkânsız sabit durumlar (örnek: sipariş durumu, kullanıcı rolleri).
Performans açısından, Enterprise AI platform by UBOS gibi büyük veri işleme çözümlerinde, lookup table kullanımı, veri modelinin esnekliğini artırırken, enum tipleri ise mikro‑servislerde sabit konfigürasyonlar için tercih edilir.
Avantajlar ve Dezavantajlar
Lookup Table Avantajları
- Kolay ekleme ve silme işlemleri.
- Referans verileri merkezi bir yerde tutarak veri bütünlüğü ve normalizasyon sağlar.
- İlişkisel sorgularda
JOINile zengin veri çekme imkanı. - İndeksleme sayesinde büyük veri setlerinde yüksek PostgreSQL performans elde edilebilir.
Lookup Table Dezavantajları
- Her sorguda ekstra
JOINmaliyeti. - Uygulama katmanında ek kod (join yönetimi) gerekebilir.
Enum Type Avantajları
- Sorgularda
JOINihtiyacı yoktur; doğrudan değer karşılaştırması hızlıdır. - Veri bütünlüğü PostgreSQL tarafından otomatik olarak sağlanır.
- Tip tanımı, kod içinde sabit bir referans olarak kullanılabilir, tip güvenliği artar.
Enum Type Dezavantajları
- Yeni değer eklemek
ALTER TYPEile sınırlıdır ve büyük tablolarda kilitlenme riski taşır. - Değer listesi uygulama dışı bir yerde (veritabanı) tutulduğundan, UI‑katmanında dinamik listeleme zorlaşabilir.
- Çok sayıda enum değeri performans ve bakım sorunlarına yol açabilir.
Sonuç ve Öneriler
PostgreSQL’de lookup table ve enum type seçiminde aşağıdaki en iyi uygulamaları göz önünde bulundurmanız önerilir:
- Değerlerin değişim sıklığını değerlendirin: Sık güncellenen listeler için lookup table, sabit ve nadir değişen değerler için enum tercih edin.
- Performans testleri yapın: Özellikle büyük veri setlerinde
JOINmaliyetini ölçün; gerekirse AI SEO Analyzer gibi araçlarla sorgu planlarını analiz edin. - Veri bütünlüğü gereksinimlerini netleştirin: Foreign key kısıtlamalarıyla tam bütünlük gerekiyorsa lookup table, basit enum kontrolü yeterli ise enum kullanın.
- Bakım süreçlerini planlayın: Yeni değer ekleme sıklığı yüksekse, lookup table daha az operasyonel risk taşır.
- Uygulama mimarisine uyum: Mikro‑servislerde tip güvenliği ve düşük gecikme için enum, monolitik veya veri‑ağır sistemlerde esnekliği artırmak için lookup table tercih edin.
Her iki yöntemin de PostgreSQL veri bütünlüğü ve performans açısından güçlü yönleri vardır; kritik karar, iş gereksinimlerinin teknik detaylarıyla eşleşmelidir.
UBOS platformu, bu kararları desteklemek için UBOS platform overview sayfasında sunduğu veri modelleme araçları ve Workflow automation studio ile otomatik migration senaryoları sayesinde hem lookup table hem de enum tiplerini sorunsuzca yönetmenize olanak tanır.
İlgili Kaynaklar ve UBOS Çözümleri
PostgreSQL tasarımını daha da güçlendirmek ve AI destekli analizler eklemek isterseniz aşağıdaki UBOS kaynakları faydalı olabilir:
- UBOS solutions for SMBs – Küçük ve orta ölçekli işletmeler için veri tabanı entegrasyonları.
- UBOS templates for quick start – Hızlı prototipleme ve veri modelleme şablonları.
- AI Article Copywriter – Teknik dokümantasyon ve blog içeriklerinin otomatik üretimi.
- AI Chatbot template – Veri tabanı sorularını doğal dilde yanıtlayan botlar.
- UBOS partner program – İş ortaklarıyla entegrasyon ve danışmanlık fırsatları.
- UBOS pricing plans – Farklı ölçeklerde maliyet optimizasyonu.
Bu bilgiler ışığında, PostgreSQL projelerinizde lookup table ve enum type arasında bilinçli bir tercih yaparak, veri bütünlüğü, performans ve bakım maliyetlerini dengeleyebilirsiniz.
© 2025 UBOS – Tüm hakları saklıdır.
Andrii Bidochko
CTO UBOS
Andrii Bidochko is an AI entrepreneur and researcher focused on AI agents, reinforcement learning, and autonomous systems. He writes about the technologies shaping the future of machine intelligence, from frontier models and agent architectures to real-world AI applications.